AI 視覺訓練如何找最佳參數?超參數實驗流程與紀錄方法
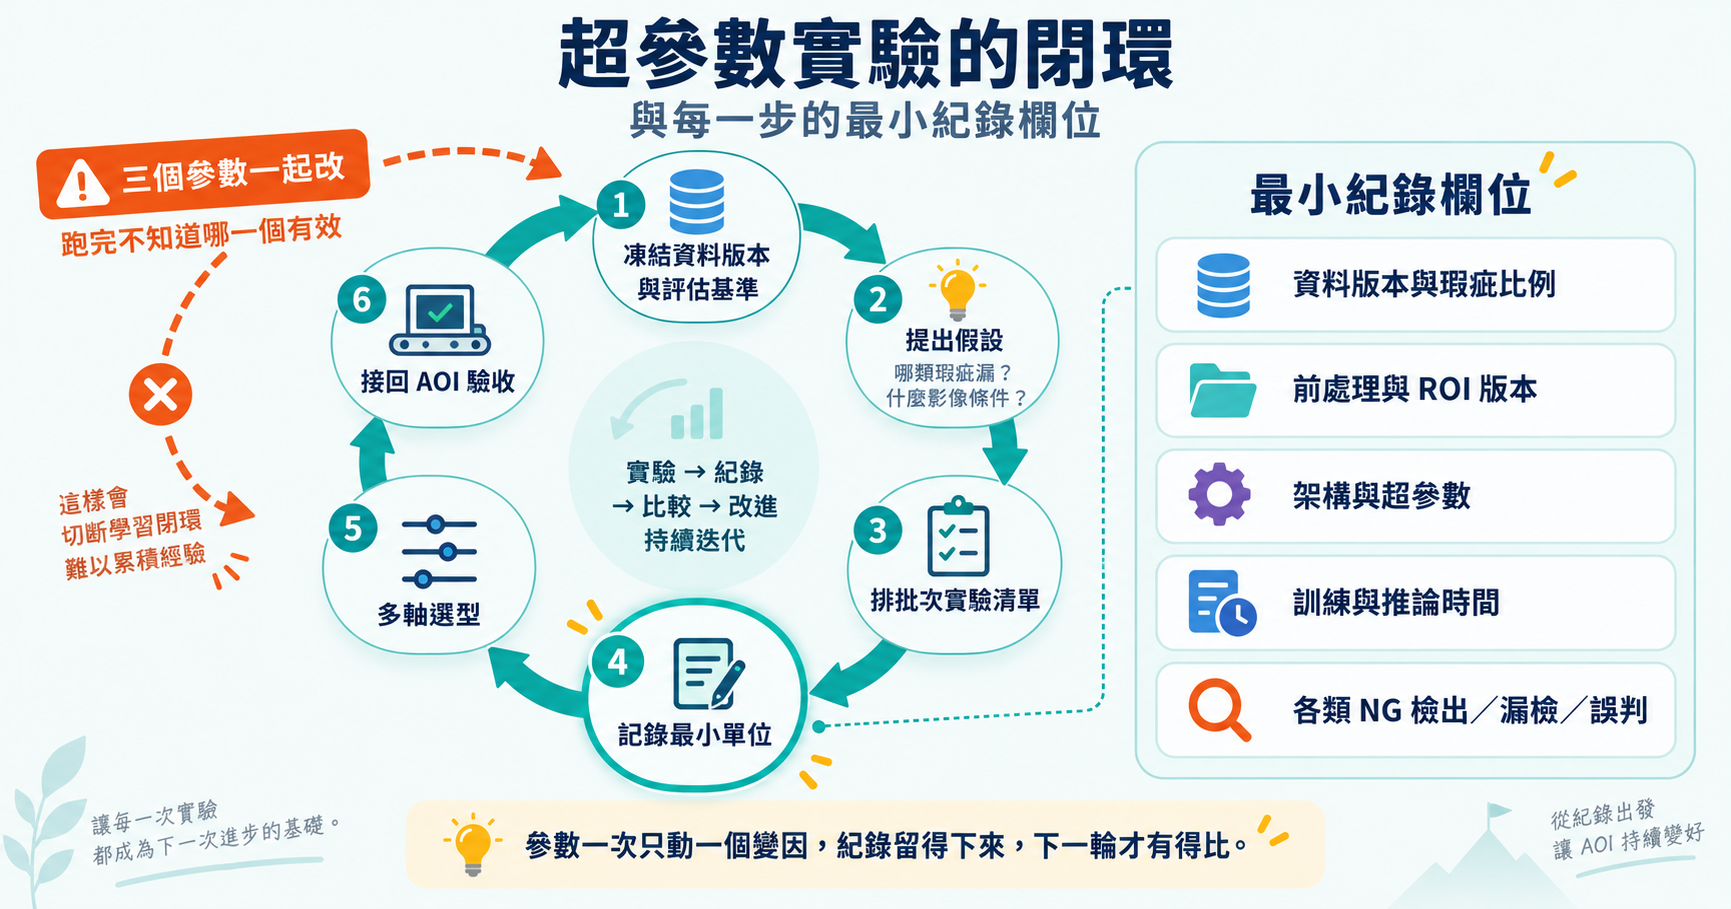
AI 模型不準時,第一個反應常是調 learning rate、加 iteration、換 image size。問題是三個一起改,跑出結果也不知道到底是哪一個有效。
我們把超參數調校當成實驗管理,而不是反覆碰運氣。每一輪要有假設、資料版本、參數範圍、評估指標與可回溯的結果,模型才會越調越可靠。
晟技術審閱:晟格科技 AOI 應用工程團隊
最後實質更新:2026 年 9 月 7 日
最後實質更新:2026 年 9 月 7 日
先固定資料和評估基準
超參數實驗前,先凍結資料版本、標註規則、訓練/驗證/測試切分與評估指標。資料一邊換、參數一邊調,最後的分數無法比較,也無法知道模型是否真的變好。
哪些參數該調,哪些問題不靠調參解
| 項目 | 要觀察的影響 |
|---|---|
| 影像大小 | 小瑕疵能否保留、GPU 記憶體與推論時間 |
| 學習率與迭代次數 | 收斂、過擬合與不同資料批次的穩定度 |
| 資料擴增 | 是否模擬真實變異,而不是製造不存在的影像 |
若問題其實是光源漂移、標註不一致或 NG 樣品太少,調再多參數也救不了。
用批次實驗取代人工盯訓練
把參數組合排成實驗清單,讓系統依序訓練並記錄結果。每一筆實驗至少保留資料版本、模型版本、參數、訓練時間、檢出、誤判與推論時間。完成後再比較,不要只挑最高分的那一次。
一場好的超參數實驗,先回答三個問題
模型分數不夠高時,不是所有參數都該同時動。先問:哪一類瑕疵漏掉了?它發生在什麼影像條件?問題是資料、成像還是模型容量?答案不同,下一輪實驗的參數範圍也不同。
| 現象 | 先查什麼 | 適合做的實驗 |
|---|---|---|
| 訓練分數高、換批次就掉 | 資料切分、批次差異、過擬合 | 固定資料版本,比較擴增與正則化,而非只加迭代 |
| 小瑕疵經常漏掉 | 原圖解析度、切塊方式、標註邊界 | 比較影像大小、ROI 與模型輸入尺寸 |
| 模型很慢 | 前處理、模型、硬體與 I/O | 分開量測取像、前處理、推論與寫檔時間 |
批次實驗的最小紀錄單位
- 資料版本、樣本數與各類瑕疵比例。
- 影像前處理與 ROI 版本。
- 模型架構、權重起點與超參數。
- 訓練時間、推論時間與使用硬體。
- 每一類 NG 的檢出、漏檢與 OK 誤判。
不要只選排行榜第一名
最高分的模型可能只贏在某一批容易資料,也可能速度太慢、誤判太高。量產選型要同時看關鍵瑕疵、跨批次穩定度、節拍、可維護性和重新訓練成本。
有時候第二名模型少一點分數,卻更容易在現場穩定運行,才是更好的選擇。
把超參數最佳化接回 AOI 驗收
模型的最佳參數不只由驗證分數決定,還必須符合現場判定規格。當某個參數組合提高檢出卻大幅增加誤判,或讓完整 cycle time 超過送料節拍,就不能直接當成量產答案。
| 量產問題 | 實驗表要加的欄位 | 決策用途 |
|---|---|---|
| 漏檢關鍵瑕疵 | 依瑕疵類型拆開的檢出結果 | 避免總分掩蓋少數高風險瑕疵 |
| 人工複判太多 | OK 誤判、信心區間與複判件數 | 估算實際人力成本 |
| 換批後失效 | 批次、日期和成像條件 | 規劃重新訓練與變更驗證 |
把模型實驗變成可交接的工程流程
若您正在導入 AI 檢測,請先整理目前資料、目標瑕疵、標註規則、現有模型結果與量產節拍。工程團隊可協助您建立可比較的實驗表,找出最值得先改善的變因。
討論 AI 實驗設計 →